Model AI Lokal vs Cloud: Perbandingan Jujur Buat Developer Indonesia
Model AI lokal vs cloud: perbandingan jujur soal biaya, privasi data, latency, dan kualitas. Panduan lengkap memilih yang tepat untuk developer Indonesia.
Panduan
24 Oktober 2026 · 6 menit baca · Panglima Router
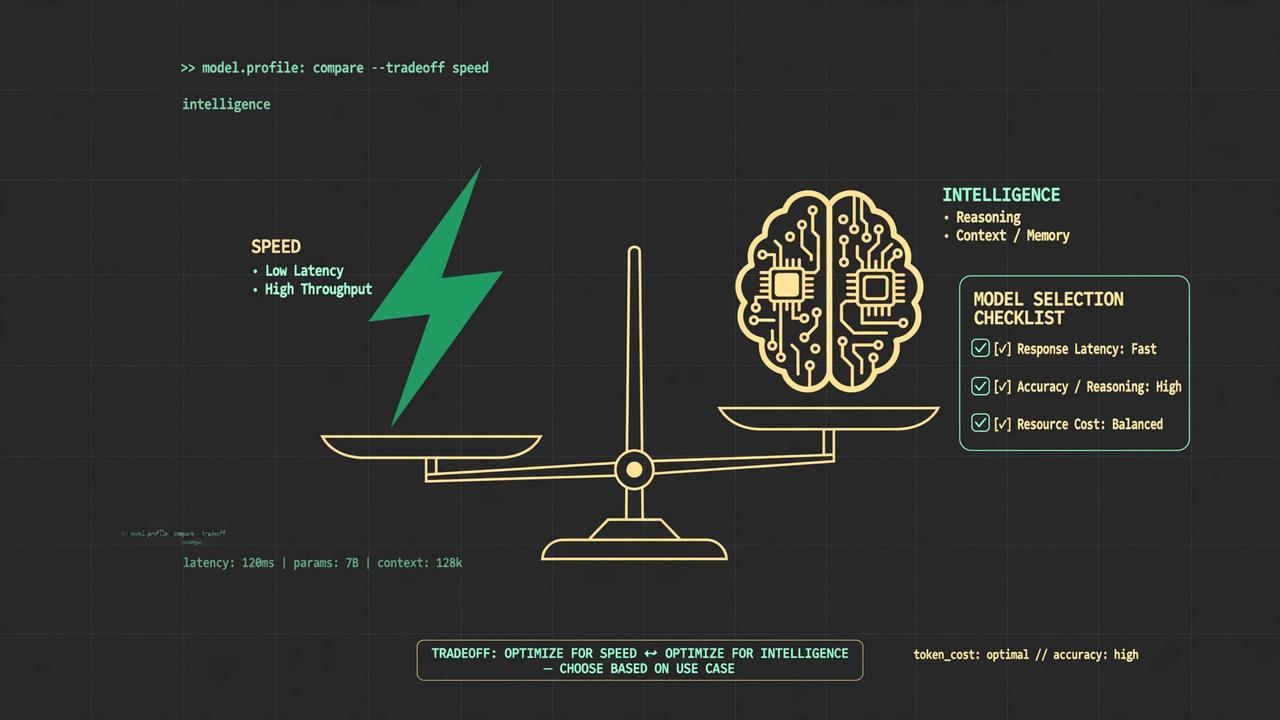
Salah satu keuntungan memakai AI router: kamu bisa ganti model kapan saja tanpa ganti kode — cukup ganti satu string nama model. Tapi kebebasan itu punya efek samping: bingung pilih yang mana. Katalog halaman Model penuh pilihan, dan tiap model mengklaim keunggulannya sendiri.
Kabar baiknya, memilih model bukan soal menghafal benchmark. Ini soal menjawab empat pertanyaan berurutan. Artikel ini framework-nya.
Langkah yang paling sering dilewatkan — dan paling menentukan. "Model terbaik" tidak ada; yang ada hanya "model paling cocok untuk tugas X". Definisikan dulu tugasmu se-spesifik mungkin:
| Tugas | Karakter yang dibutuhkan |
|---|---|
| Chat / Q&A umum | General-purpose yang seimbang sudah cukup |
| Coding (nulis, review, debug) | Kuat di reasoning dan pemahaman kode |
| Tugas cepat bervolume besar (klasifikasi, ekstraksi, ringkasan) | Kecil, cepat, murah per request |
| Riset dan reasoning panjang | Besar, teliti, context window lega |
| Aplikasi interaktif (chatbot customer) | Latency rendah — kecepatan adalah UX |
Tulis tugasmu dalam satu kalimat sebelum membuka katalog. Contoh: "meringkas 200 email customer per hari menjadi 3 kategori" — kalimat ini langsung mengeliminasi model-model raksasa yang lambat dan mengarahkanmu ke model cepat.
Kesalahan klasik: memilih model terbesar "biar aman". Model besar untuk tugas klasifikasi sederhana itu seperti naik truk kontainer untuk beli indomie — bisa, tapi lambat dan boros.
Jangan percaya klaim, jangan percaya benchmark generik — uji sendiri dengan prompt yang mewakili tugas aslimu. Caranya:
Di Panglima Router kamu bisa melakukan ini tanpa tulis kode — cukup chat dari bot Telegram, ganti model dari menu, kirim prompt yang sama. Butuh sekitar 10 menit untuk 3 model, dan hasilnya jauh lebih bisa dipercaya daripada baca leaderboard.
Satu tips penilaian: untuk tugas faktual, turunkan temperature (0–0.3) supaya jawaban stabil dan perbandinganmu adil. Temperature tinggi membuat output variatif — bagus untuk brainstorming, buruk untuk benchmarking.
Tiga metrik ini cukup untuk hampir semua keputusan:
Tidak ada jalan pintas: baca hasilnya dan nilai sendiri. Untuk tugasmu, "bagus" itu seperti apa? Akurat? Formatnya rapi? Tidak ngarang? Buat checklist kecil 3–4 kriteria, lalu skor tiap kandidat. Kualitas adalah alasan utama orang pindah model — jangan dikalahkan oleh metrik lain kalau kualitasnya belum masuk standar.
Ada dua kecepatan yang berbeda: time to first token (berapa cepat jawaban mulai muncul — penting untuk streaming di UI chat) dan throughput (berapa cepat seluruh jawaban selesai). Untuk chatbot customer-facing, time to first token di bawah 2 detik terasa "responsif"; di atas 5 detik pengguna mulai mengira aplikasinya hang.
Untuk batch processing yang jalan di background, kecepatan hampir tidak penting — yang penting benar.
Kalau tugasmu melibatkan dokumen panjang — kontrak, codebase, riwayat chat panjang — kamu butuh model dengan context window yang muat. Aturan praktis: kebutuhan konteks aslimu dikali dua, untuk ruang bernapas (instruksi system + riwayat + output). Kekurangan konteks bukan masalah yang bisa diakali dengan prompt engineering — kalau tidak muat, ya tidak muat.
Pola yang umum berhasil, terutama kalau kamu masih meraba-raba:
Mulai kecil, naik kalau perlu. Pakai model cepat untuk iterasi dan development — feedback loop-nya pendek, kamu bisa coba banyak hal dalam sejam. Naik ke model yang lebih pintar untuk kasus sulit, evaluasi final, atau path production yang kritis.
Karena ganti model cuma ganti satu string, pola ini murah dilakukan. Banyak tim menjalankan dua model sekaligus: model cepat untuk 80% kasus gampang, model pintar sebagai fallback untuk 20% kasus yang gagal di model cepat. Router membuat arsitektur seperti ini trivial — satu endpoint, dua nama model, satu if di kodemu.
Aturan praktis: kalau kamu belum bisa merasakan bedanya, pilih yang lebih cepat.
Kalimat ini kedengarannya meremehkan, tapi justru disiplin yang bagus. Perbedaan kualitas yang tidak bisa kamu rasakan dalam pengujian tidak akan dirasakan pengguna juga — sementara perbedaan kecepatan selalu terasa. Dan kalau nanti kebutuhanmu naik kelas, naik model semudah ganti satu string di konfigurasi.
Jebakan 1: terpaku pada satu model "jagoan". Model yang bagus untuk coding belum tentu bagus untuk ringkasan cepat. Katalog itu menu, bukan ranking — pilih per tugas.
Jebakan 2: menguji dengan prompt yang salah. "Tulis puisi tentang hujan" tidak memberi informasi apa pun tentang kemampuan model meringkas invoice. Uji dengan data aslimu atau jangan uji sama sekali.
Jebakan 3: mengabaikan format output. Untuk aplikasi, konsistensi format (JSON rapi, tidak ada teks ngawur di luar struktur) sering lebih penting daripada kecerdasan mentah. Model yang sedikit kurang pintar tapi selalu mengembalikan JSON valid biasanya menang di production.
Jebakan 4: tidak mencatat keputusan. Tiga bulan dari sekarang kamu tidak akan ingat kenapa memilih model A. Catat: tugasnya apa, kandidatnya apa, skornya berapa, tanggal pengujiannya. Satu paragraf cukup.
Jebakan 5: memilih sekali untuk selamanya. Katalog model berubah — model baru masuk tiap bulan. Jadwalkan evaluasi ulang tiap beberapa bulan, atau saat ada keluhan kualitas dari pengguna. Dengan router, evaluasi ulang semurah ganti string.
Buka halaman Model dengan kacamata framework di atas:
Kalau kamu memakai API, ID model yang kamu pilih tinggal dipakai di parameter model — contoh lengkapnya ada di API Pertamamu. Dan kalau aplikasimu sudah jalan di OpenAI, pindahnya cuma ganti baseURL — lihat Migrasi dari OpenAI.
Dua sampai tiga kandidat per tugas sudah cukup. Lebih dari itu biasanya buang waktu — perbedaannya makin kecil sementara effort evaluasinya membengkak. Kalau dua kandidat hasilnya imbang, pilih yang lebih cepat atau yang kamu lebih kenal perilakunya.
Tidak. Lebih besar biasanya berarti lebih teliti untuk reasoning kompleks, tapi juga lebih lambat dan lebih mahal. Untuk tugas sederhana seperti klasifikasi atau ekstraksi field, model kecil yang cepat sering hasilnya setara dengan waktu tunggu sepersekian. Uji, jangan asumsi.
Itu justru alasan memakai router. Ganti nama model di konfigurasimu, uji ulang dengan prompt aslimu, deploy. Tidak ada migrasi API, tidak ada SDK baru, tidak ada kontrak baru. Satu baris berubah, selesai.
Boleh dan umum. Banyak tim develop dengan model cepat (iterasi murah) lalu menjalankan evaluasi final dengan model yang akan dipakai di production. Yang penting: evaluasi final selalu dengan model production — jangan mengasumsikan hasil model A berlaku untuk model B.
Grup diskusi tempat yang pas — ceritakan tugasmu, biasanya ada yang sudah mencoba model untuk kasus mirip. Pengalaman nyata pengguna lain sering lebih berguna daripada spesifikasi di atas kertas.
Memilih model bukan ujian — tidak ada jawaban benar yang universal. Definisikan tugasmu, uji 2–3 kandidat dengan data asli, ukur tiga metrik, mulai dari yang kecil. Framework empat pertanyaan ini cukup untuk 90% keputusan. Sisanya? Coba langsung di @panglimarouter_bot — paket Trial Rp5.000 cukup untuk satu sesi evaluasi penuh.
Model AI lokal vs cloud: perbandingan jujur soal biaya, privasi data, latency, dan kualitas. Panduan lengkap memilih yang tepat untuk developer Indonesia.
Tujuh praktik keamanan API key: simpan di environment variable, pisahkan key testing dan production, rotasi rutin, batasi akses, dan pantau pemakaian.
Mulai sekarang
Mulai dari Rp5.000. Bayar QRIS atau USDC, langsung dapat API key.