Apa Artinya OpenAI-Compatible API dan Kenapa Itu Penting
OpenAI-compatible API adalah API yang memakai format request OpenAI sehingga kodemu bisa ganti provider tanpa rewrite. Pahami konsep, format, dan batasannya.
Konsep
9 Oktober 2026 · 6 menit baca · Panglima Router
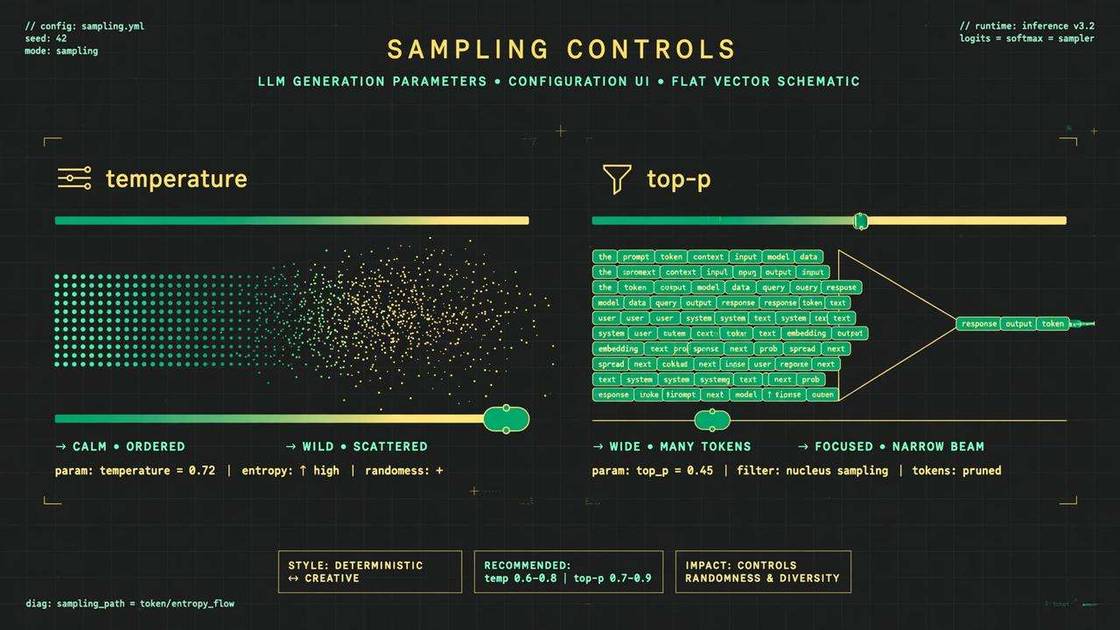
Pernah dapat jawaban AI yang kaku dan itu-itu saja? Atau sebaliknya — terlalu ngawur sampai nggak bisa dipakai? Kemungkinan besar masalahnya bukan di modelnya, tapi di dua parameter kecil yang sering diabaikan: temperature dan top-p.
Dua parameter ini mengontrol satu hal: seberapa "berani" model mengambil risiko saat memilih kata berikutnya. Pahami keduanya, dan kamu bisa menyetel perilaku model sesuai kebutuhan — dari presisi mesin sampai liarnya brainstorming.
Temperature adalah parameter angka (biasanya 0 sampai 2) yang mengatur seberapa acak pilihan kata model: nilai rendah membuat jawaban deterministik dan konsisten, nilai tinggi membuat jawaban bervariasi dan kreatif.
Cara kerja sederhananya begini. Setiap kali model mau menulis kata berikutnya, dia punya daftar kandidat kata dengan skor probabilitas. Temperature mengatur seberapa "tegas" dia mengikuti skor itu:
Analoginya seperti lempar dadu yang bisa disetel. Temperature 0 itu dadunya selalu keluar angka 6. Temperature tinggi itu dadunya normal — bisa keluar apa saja.
Top-p (nucleus sampling) adalah parameter angka (0 sampai 1) yang membatasi pilihan kata model hanya pada kelompok kata paling mungkin yang total probabilitasnya mencapai nilai p.
Kalau temperature mengatur "seberapa berani", top-p mengatur "dari kolam sebesar apa" model boleh memilih. Contoh: dengan top-p 0.9, model hanya mempertimbangkan kata-kata yang — kalau diurut dari paling mungkin — total probabilitas kumulatifnya 90%. Kata-kata aneh di ekor distribusi langsung dibuang, tidak peduli temperature-nya berapa.
Dengan top-p 0.1, kolamnya kecil sekali: hampir selalu kata yang paling mungkin. Dengan top-p 1.0, tidak ada batasan — semua kata dipertimbangkan (ini default di banyak API).
Keduanya mengontrol keacakan, tapi lewat mekanisme berbeda:
| Temperature | Top-P | |
|---|---|---|
| Yang diatur | Ketegasan mengikuti probabilitas | Ukuran kolam kandidat kata |
| Nilai rendah | Deterministik, konsisten | Sangat fokus, aman |
| Nilai tinggi | Variatif, berisiko | Kolam lebar, bisa aneh |
| Efek samping nilai ekstrem | Ngawur total | Hampir tidak ada variasi |
Praktik umum: atur salah satu, biarkan yang lain di default. Kebanyakan developer mengatur temperature dan membiarkan top-p di 1.0 — atau sebaliknya. Mengutak-atik keduanya sekaligus bikin perilakunya susah diprediksi dan susah di-debug.
Tidak ada nilai "benar" universal — yang ada nilai yang cocok untuk tugasmu:
| Kebutuhan | Temperature | Top-P | Alasan |
|---|---|---|---|
| Kode, data, jawaban faktual | 0 – 0.3 | 0.9 – 1.0 | Konsisten, minim halusinasi gaya |
| Ringkasan dokumen | 0.3 – 0.5 | 1.0 | Setia ke sumber, bahasa tetap natural |
| Chatbot / asisten umum | 0.7 | 1.0 | Seimbang: natural tapi terkendali |
| Menulis kreatif, caption | 0.8 – 1.0 | 0.9 – 1.0 | Variasi gaya, tetap koheren |
| Brainstorming liar | 1.0 – 1.3 | 0.95 | Maksimalkan kejutan |
Catatan: ini titik awal. Setiap model merespons parameter sedikit berbeda — model yang satu "kreatif" di 0.8, yang lain baru di 1.0. Uji dengan prompt nyatamu.
Di API yang OpenAI-compatible seperti Panglima Router, kedua parameter tinggal ditambah ke body request:
import requests

response = requests.post(
    "https://api.panglimarouter.xyz/v1/chat/completions",
    headers={"Authorization": "Bearer ISI_API_KEY_KAMU"},
    json={
        "model": "nama-model-pilihanmu",
        "temperature": 0.3,
        "messages": [
            {"role": "user", "content": "Jelaskan perbedaan HTTP dan HTTPS"}
        ],
    },
)
Contoh di atas memakai temperature rendah karena pertanyaannya faktual — kita mau jawaban yang konsisten dan tepat, bukan yang puitis. Untuk contoh request lengkap dari nol, lihat tutorial API pertama.
Mengatur keduanya ekstrem sekaligus. Temperature 1.5 plus top-p 0.5 itu seperti injak gas sambil tarik rem — hasilnya tidak terprediksi dan susah diulang. Pilih satu sebagai tuas utama.
Temperature tinggi untuk tugas faktual. Minta model menjelaskan konsep medis dengan temperature 1.2 lalu heran kenapa jawabannya "kreatif". Tugas faktual = temperature rendah. Selalu.
Tidak mencatat parameter saat eksperimen. Kamu bandingkan dua model tapi satu pakai temperature 0.2 dan satunya 0.9, lalu simpulkan modelnya yang beda. Padahal yang beda settingnya. Saat membandingkan model, samakan parameternya dulu.
Mengira temperature 0 menghilangkan halusinasi. Temperature rendah bikin jawaban konsisten, tapi model tetap bisa konsisten salah. Kalau model tidak tahu jawabannya, temperature 0 cuma bikin dia salah dengan percaya diri. Verifikasi fakta penting dari sumber lain.
Biar terasa bedanya, bayangkan prompt yang sama dikirim dua kali dengan setting berbeda:
Prompt: "Berikan 3 ide nama untuk kedai kopi di Bandung."
Dengan temperature 0.2, kamu mungkin dapat: "Kopi Bandung, Kedai Kopi Pagi, Kopi Dago" — aman, deskriptif, tapi datar. Jalankan tiga kali, hasilnya hampir identik.
Dengan temperature 1.0, kamu mungkin dapat: "Ngopi di Dago, Sore Itu Kopi, Kafein & Kabut" — lebih berani, lebih berkesan, tapi sesekali muncul yang aneh seperti "Kopi Terbang". Jalankan tiga kali, tiap hasilnya beda.
Tidak ada yang "salah" — yang ada yang "cocok". Buat brainstorming nama brand, variasi itu justru yang kamu cari. Buat mengekstrak tanggal dari invoice, variasi itu musuhmu. Latihan kecil ini layak dicoba sendiri: ambil satu prompt dari kerjaanmu, jalankan di temperature 0.2, 0.7, dan 1.2, lalu rasakan perbedaannya. Pemahaman intuitif seperti ini lebih nempel daripada sekadar baca definisi.
Satu hal lagi yang sering ditanya: apakah setting ini memengaruhi kualitas model? Tidak — model yang sama tetap sepintar yang sama. Yang berubah hanya strategi pengambilan keputusannya: main aman atau berani ambil risiko. Model bodoh dengan temperature rendah tetap bodoh, cuma lebih konsisten bodohnya.
Parameter ini bukan pengganti prompt yang baik — mereka pasangannya. Prompt yang jelas menentukan arah jawaban; temperature/top-p menentukan gaya perjalanannya. Prompt berantakan dengan temperature sempurna tetap menghasilkan jawaban berantakan. Fondasi prompt yang benar dibahas di prompt engineering dasar.
Umumnya 1.0 (atau 0.7 tergantung provider). Artinya kalau kamu tidak pernah mengatur, model berjalan di mode "seimbang" — cukup variatif untuk terasa natural. Untuk tugas yang butuh konsistensi, turunkan secara eksplisit.
Tidak langsung. Temperature tidak mengubah jumlah token yang diproses — biaya dan kecepatan ditentukan oleh panjang prompt, panjang jawaban, dan model yang dipakai. Yang berubah hanya karakter jawabannya.
Beberapa model tetap punya sedikit keacakan internal, dan infrastruktur serving (batching, paralelisasi) bisa menimbulkan variasi kecil. Temperature 0 membuat hasil hampir deterministik, bukan jaminan 100% identik.
Top-p berguna saat kamu mau variasi tapi tetap dalam batas aman — misalnya chatbot yang harus natural tapi tidak boleh ngomong aneh. Turunkan top-p ke 0.9 sambil biarkan temperature moderat: kolam katanya disaring, tapi pemilihannya tetap hidup.
Hampir semua model modern mendukung temperature. Top-p juga didukung luas, tapi ada model tertentu (terutama yang fokus reasoning) yang mengabaikan atau membatasi parameter sampling. Cek dokumentasi model yang kamu pakai di katalog.
Secara teknis sebagian API mengizinkan, tapi praktisnya tidak berguna. Temperature di atas 2 hampir selalu menghasilkan teks sampah yang tidak koheren, sedangkan top-p 0 berarti kolam kandidatnya kosong. Tetaplah di rentang yang masuk akal (temperature 0–1.5, top-p 0.1–1.0) kecuali kamu memang sedang bereksperimen.
OpenAI-compatible API adalah API yang memakai format request OpenAI sehingga kodemu bisa ganti provider tanpa rewrite. Pahami konsep, format, dan batasannya.
Pahami cara kerja model routing: alur request dari kode kamu ke provider, kenapa satu API key cukup, dan contoh request OpenAI-compatible yang siap pakai.
Mulai sekarang
Mulai dari Rp5.000. Bayar QRIS atau USDC, langsung dapat API key.