Panduan Memilih Model AI 2026: Sesuaikan Kebutuhan, Bukan Tren
Bingung pilih model AI? Panduan praktis 2026: kenali kebutuhanmu, bandingkan model dari sisi tugas, kecepatan, dan biaya — bukan sekadar ikut tren sesaat.
Panduan
11 Oktober 2026 · 7 menit baca · Panglima Router
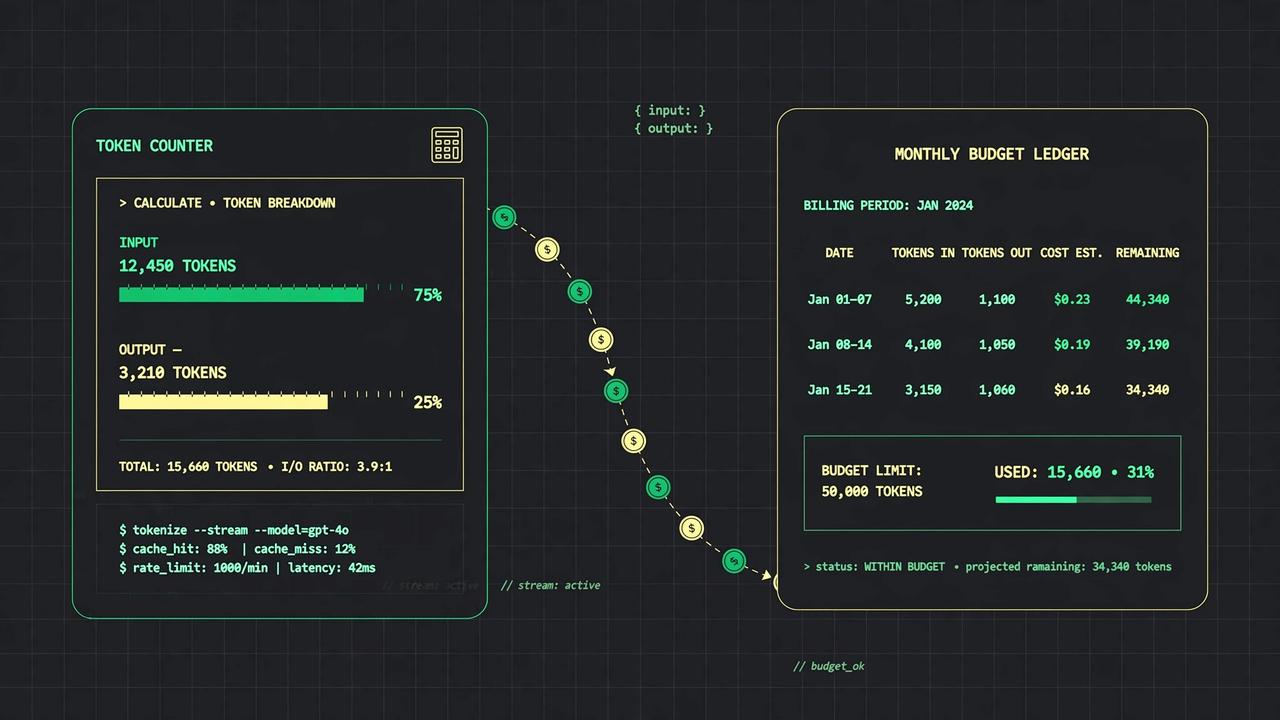
Tagihan API AI yang membengkak hampir selalu berawal dari hal yang sama: orang tidak tahu token itu apa, berapa banyak yang dipakai, dan bagaimana menghitungnya sebelum jalan. Aku tulis panduan ini supaya kamu punya cara berpikir yang rapi — dari konsep token sampai cara menyusun budget bulanan yang realistis.
Artikel ini umum dan berlaku untuk hampir semua provider API AI. Angka paket yang kusebut sebagai contoh diambil dari harga Panglima Router supaya contohnya konkret, tapi rumus-rumusnya bisa kamu pakai di mana pun.
Token adalah unit terkecil yang dihitung provider saat kamu memakai API AI. Bukan karakter, bukan kata — token adalah potongan teks hasil pemecahan (tokenisasi) oleh model. Satu kata bahasa Inggris rata-rata jadi 1–1,5 token. Bahasa Indonesia biasanya sedikit lebih boros: satu kata bisa jadi 1,5–2 token karena tokenizer umumnya dilatih lebih banyak di teks Inggris.
Contoh kasar:
Kenapa ini penting? Karena biaya API AI hampir selalu dihitung per token, dibagi dua: token input (prompt yang kamu kirim) dan token output (jawaban yang dihasilkan model). Harga token output biasanya 2–4 kali lebih mahal dari token input, karena menghasilkan teks butuh komputasi lebih besar.
Setiap tagihan API AI bisa diurai jadi tiga komponen sederhana.
Semua yang kamu kirim ke model: system prompt, instruksi, konteks, riwayat percakapan, dan pertanyaan user. Ini yang paling sering diremehkan. Kalau kamu membangun chatbot dengan system prompt 2.000 token dan riwayat 10 pesan terakhir, setiap request bisa menghabiskan 5.000+ token input sebelum user mengetik apa pun.
Jawaban model. Ini yang paling mahal per tokennya. Request yang meminta "tulis artikel 1.000 kata" bisa menghasilkan 1.500+ token output dalam sekali jalan.
Dikalikan frekuensi. 100 request sehari × 30 hari = 3.000 request sebulan. Kecil per request, besar kalau dikali.
Rumus dasarnya:
biaya = (token_input × harga_input + token_output × harga_output) × jumlah_request
Sesederhana itu. Yang bikin orang kaget bukan rumusnya, tapi kenyataan bahwa mereka tidak pernah mengukur ketiga angka itu sebelum production.
Langkah praktisnya begini.
Langkah 1: ukur satu request yang representatif. Ambil satu interaksi tipikal di aplikasimu — misalnya satu pertanyaan user ke chatbot dengan riwayat 5 pesan. Hitung tokennya. Banyak library tokenizer open-source yang bisa dipakai lokal tanpa mengirim apa pun ke provider. Atau cara paling gampang: catat pemakaian token dari respons API selama seminggu, lalu ambil rata-ratanya.
Langkah 2: pisahkan input dan output. Jangan digabung. Karena harganya beda, gabungan angka tanpa pemisahan bikin estimasi meleset jauh.
Langkah 3: kalikan dengan volume. Estimasi request per hari dari trafik aplikasimu. Kalau belum launch, pakai skenario: pesimis, realistis, optimis.
Langkah 4: tambah buffer 20–30%. Percakapan nyata selalu lebih panjang dari skenario. User bertanya lanjutan, model menjawab lebih panjang dari perkiraan, ada retry saat error. Buffer ini yang membedakan estimasi rapi dan tagihan kejutan.
Misalnya kamu menjalankan chatbot customer service:
Total per bulan:
Dengan angka ini kamu tinggal mengalikan harga per juta token dari provider pilihanmu. Kalau memakai model lewat katalog model yang harganya transparan per paket, kamu bisa langsung membandingkan: apakah kebutuhan 9 juta token/bulan ini muat di paket yang kamu pilih, atau perlu naik satu tingkat? Lihat daftar harga dan hitung — jangan tebak.
Setelah tahu kebutuhan token, susun budget dengan struktur ini:
Aturan praktis yang kupakai: kalau estimasi biaya inti sudah di atas 70% dari budget yang kamu tetapkan, turunkan ekspektasi atau optimalkan dulu sebelum launch. Jangan launch dengan asumsi "nanti juga turun sendiri". Tidak turun sendiri.
System prompt yang kepanjangan. System prompt dikirim di setiap request. Prompt 3.000 token yang dipakai 10.000 kali sebulan = 30 juta token input untuk teks yang sama berulang-ulang. Padatkan. Kalau ada bagian yang statis dan panjang, pertimbangkan arsitektur yang tidak mengirimnya setiap kali.
Tidak membatasi output. Parameter seperti max_tokens ada untuk dipakai. Tanpa batas, model bisa menjawab 2.000 token untuk pertanyaan yang cukup dijawab 200 token. Set batas yang masuk akal per use case.
Retry tanpa backoff dan tanpa batas. Error sesekali itu normal. Retry 5 kali untuk setiap request gagal tanpa jeda bisa melipatgandakan biaya saat provider sedang bermasalah. Batasi retry, kasih jeda, dan log setiap retry supaya kelihatan di monitoring.
Memakai model besar untuk tugas kecil. Klasifikasi sentimen, ekstraksi entitas, dan ringkasan pendek tidak butuh model paling canggih. Ini topik yang kubahas detail di strategi menghemat biaya API AI — intinya, cocokkan ukuran model dengan sulitnya tugas.
Lupa mematikan eksperimen. API key untuk testing yang dibiarkan aktif di script cron atau notebook yang terlupa bisa jalan berminggu-minggu tanpa ada yang sadar. Key testing harus punya umur pendek dan dirotasi rutin. Soal ini ada panduan tersendiri: keamanan API key.
Ada dua pola bayar yang umum: bayar per pemakaian (per token/request) dan paket berlangganan dengan kuota. Pola per token cocok kalau pemakaianmu tidak menentu atau masih tahap eksperimen. Tapi kalau kamu sudah tahu pola pemakaiannya — misalnya chatbot dengan 200 request/hari yang stabil — paket bulanan dengan harga pasti biasanya lebih murah dan jauh lebih gampang dianggarkan. Tidak ada kejutan akhir bulan.
Contoh konkret dari harga Panglima Router: paket Plus Rp15.000/7 hari atau Essential Rp30.000/14 hari cocok untuk fase testing dan validasi ide — kamu tahu persis berapa yang keluar per minggu. Begitu polanya stabil, Pro Rp50.000/30 hari memberi biaya bulanan yang flat dan bisa diprediksi. Bandingkan dengan estimasi token bulananmu dari rumus di atas, lalu pilih yang totalnya paling masuk akal. Perbandingan lengkapnya kubahas di AI router vs langganan langsung.
max_tokens diset untuk setiap use caseKalau semua kotak ini tercentang, kamu sudah lebih siap dari kebanyakan orang yang launch integrasi AI pertama mereka.
Token adalah unit teks terkecil yang dihitung provider API AI untuk penagihan. Satu kata biasanya setara 1–2 token tergantung bahasa dan tokenizer yang dipakai. Biaya dihitung terpisah untuk token input (prompt yang kamu kirim) dan token output (jawaban model), dengan token output umumnya lebih mahal.
Ukur rata-rata token input dan output dari satu request yang representatif, kalikan dengan estimasi jumlah request per hari, kalikan 30 hari, lalu tambah buffer 20–30%. Rumusnya: (token_input × harga_input + token_output × harga_output) × jumlah_request. Pakai data nyata seminggu pertama untuk memperbaiki estimasi.
Penyebab paling umum: system prompt kepanjangan yang dikirim ulang setiap request, tidak ada batas max_tokens, retry berlebihan saat error, memakai model terlalu besar untuk tugas sederhana, dan eksperimen yang tidak dimatikan. Semuanya bisa dicegah dengan mengukur dulu sebelum launch.
Tergantung pola pakai. Kalau pemakaianmu stabil dan sudah terukur, paket bulanan dengan harga pasti — misalnya paket Pro Rp50.000/30 hari — biasanya lebih murah dan lebih mudah dianggarkan daripada pay-per-token yang fluktuatif. Kalau masih eksperimen, mulai dari paket kecil seperti Trial Rp5.000/1 hari atau Plus Rp15.000/7 hari.
Pisahkan API key production dan testing, catat pemakaian token per request, pasang alert saat pemakaian mencapai 80% dari budget, dan review mingguan untuk menemukan anomali seperti lonjakan retry atau prompt yang membengkak. Detail praktik pengamanan key ada di panduan keamanan API key.
Bingung pilih model AI? Panduan praktis 2026: kenali kebutuhanmu, bandingkan model dari sisi tugas, kecepatan, dan biaya — bukan sekadar ikut tren sesaat.
OpenAI-compatible API adalah API yang memakai format request OpenAI sehingga kodemu bisa ganti provider tanpa rewrite. Pahami konsep, format, dan batasannya.
Mulai sekarang
Mulai dari Rp5.000. Bayar QRIS atau USDC, langsung dapat API key.