Memilih Model AI untuk Project: Framework Praktis
Tidak ada model AI terbaik untuk semua hal. Framework praktis: definisikan tugas, uji A/B dengan prompt yang sama, ukur tiga metrik, mulai dari yang kecil.
Panduan
13 Oktober 2026 · 7 menit baca · Panglima Router
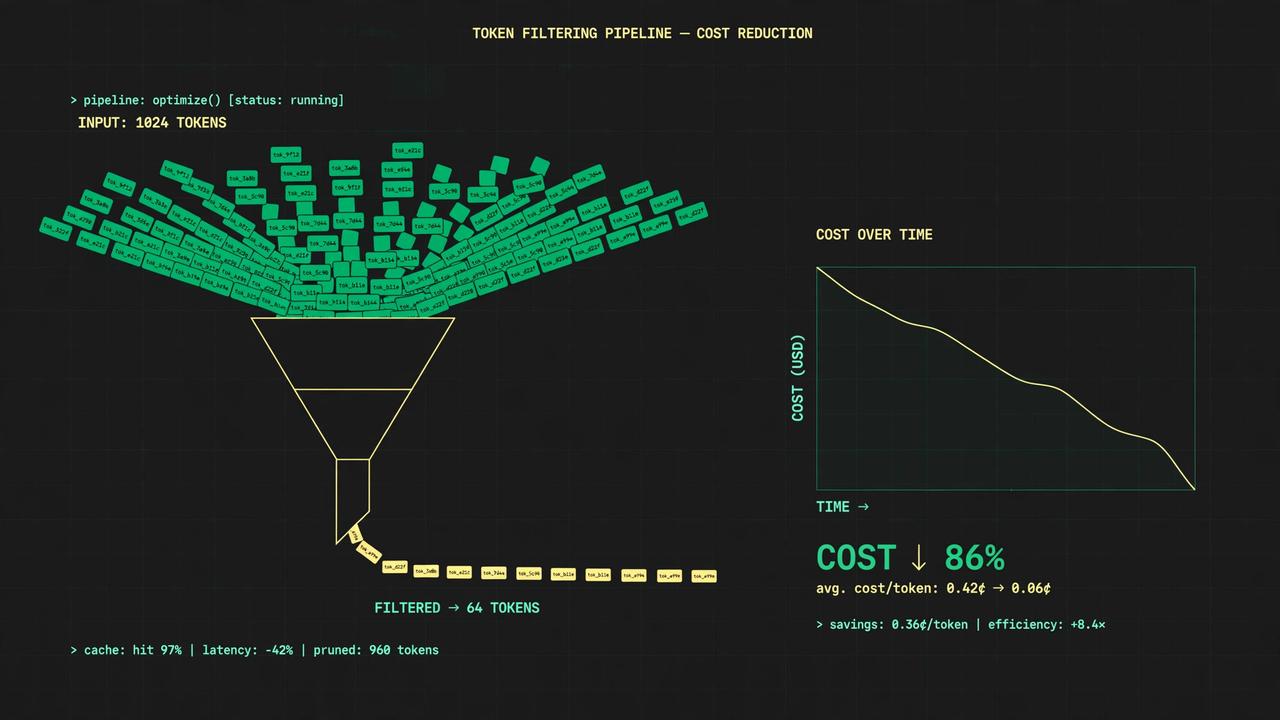
Menghemat biaya API AI bukan soal mencari yang paling murah lalu berharap kualitasnya cukup. Itu judi. Penghematan yang benar datang dari rekayasa: memakai sumber daya yang tepat untuk tiap tugas, menghilangkan pemborosan yang tidak menambah kualitas, dan mengukur semuanya. Lima strategi di bawah ini kususun dari yang dampaknya paling besar — semuanya bisa kamu terapkan minggu ini juga.
Sebelum mulai, pastikan kamu sudah tahu cara menghitung biaya API AI. Strategi tanpa angka dasar itu cuma tebakan.
Ini penghematan terbesar yang paling sering diabaikan. Banyak tim memakai satu model besar untuk semua keperluan — dari klasifikasi spam sampai penalaran kompleks — padahal 70–80% request di aplikasi tipikal adalah tugas rutin yang bisa ditangani model kecil dengan kualitas nyaris identik.
Pola yang terbukti: routing bertingkat. Bagi tugasmu jadi tiga kelas:
Contoh konkret: chatbot customer service dengan 10.000 request/bulan. Kalau 7.000 di antaranya adalah pertanyaan FAQ sederhana yang bisa dijawab model kecil, dan hanya 3.000 yang butuh model besar, kamu memangkas porsi termahal dari tagihan secara signifikan — tanpa satu pun user merasakan penurunan kualitas, karena jawaban FAQ memang tidak butuh penalaran dalam.
Cara menerapkannya paling gampang adalah lewat satu API key yang memberi akses ke banyak model sekaligus, seperti katalog model Panglima Router yang OpenAI-compatible. Kamu tidak perlu integrasi terpisah per provider — cukup ganti nama model di field model berdasarkan kelas tugas. Logikanya bisa sesederhana classifier kecil atau bahkan aturan keyword untuk memilah "tugas ringan vs berat" sebelum request dikirim.
System prompt dikirim di setiap request. Prompt 2.500 token yang dipakai 20.000 kali sebulan berarti 50 juta token input hanya untuk instruksi yang isinya sama persis setiap kali. Ini pajak bodoh yang paling mudah dihapus.
Teknik pemadatan yang aman:
Target realistis: memangkas 30–50% token input rata-rata tanpa perubahan kualitas yang terukur. Ukur dengan evaluasi kecil — 50 sampel sebelum dan sesudah — jangan asal pangkas lalu berharap.
Dua mekanisme berbeda, satu tujuan: jangan bayar dua kali untuk hal yang sama.
Caching. Banyak aplikasi mengirim prompt yang sebagian besar identik antar request — system prompt yang sama, dokumen referensi yang sama, konteks yang sama. Kalau provider atau routermu mendukung caching prompt, potongan yang berulang itu dihitung jauh lebih murah (atau gratis) setelah request pertama. Bahkan tanpa fitur caching resmi, kamu bisa cache di level aplikasi: simpan jawaban untuk pertanyaan yang sering diulang persis sama (FAQ, sapaan, template), dan layani dari cache tanpa memanggil API sama sekali. Di banyak chatbot, 10–20% pertanyaan adalah pengulangan — itu penghematan langsung 10–20%.
Batasan output. Setiap request tanpa max_tokens adalah cek kosong yang kamu tanda tangani untuk model. Set batas per use case:
Token output adalah token termahal. Memangkas rata-rata output 30% berdampak lebih besar ke tagihan daripada memangkas input 30%.
Batasan retry. Satu request gagal lalu di-retry 5 kali tanpa jeda = 6× biaya untuk nol nilai. Aturan yang waras: maksimal 2–3 retry, dengan jeda bertambah (backoff), hanya untuk error yang memang layak di-retry (timeout, 5xx, rate limit) — bukan untuk error 4xx yang akan gagal lagi dengan cara yang sama.
Ada dua pola bayar umum: pay-per-token (bayar sesuai pemakaian) dan paket bulanan flat. Memilih yang salah bisa bikin kamu bayar 2–3× lipat dari yang seharusnya.
Pay-per-token cocok untuk: fase eksperimen, pemakaian tidak menentu, atau trafik musiman yang naik-turun tajam. Kamu bayar persis yang dipakai, tidak ada komitmen.
Paket bulanan cocok untuk: pemakaian stabil yang sudah terukur. Kalau kamu sudah menghitung kebutuhan token bulananmu (lihat panduan menghitung biaya) dan angkanya konsisten, harga flat hampir selalu lebih murah per unitnya — plus anggarannya bisa diprediksi.
Contoh dengan harga Panglima Router: paket Pro Rp50.000/30 hari memberi biaya bulanan yang pasti. Bandingkan dengan skenario chatbot 200 request/hari dari panduan perhitungan biaya — kalau estimasi pay-per-token-mu mendekati atau melebihi Rp50.000/bulan, paket flat langsung lebih hemat sekaligus menghilangkan risiko tagihan kejutan. Untuk fase testing sebelum polanya stabil, mulai dari Trial Rp5.000/1 hari atau Plus Rp15.000/7 hari supaya komitmennya kecil sambil kamu mengukur angka nyatanya.
Aturan praktis: ukur dulu 2–4 minggu dengan paket kecil, lalu naik ke paket bulanan begitu polanya stabil. Jangan langsung komitmen bulanan saat angkanya masih tebakan, dan jangan bertahan di pay-per-token saat polanya sudah jelas stabil.
Semua strategi di atas akan bocor pelan-pelan tanpa monitoring. Prompt membengkak lagi setelah update fitur, retry naik saat provider bermasalah, eksperimen lupa dimatikan. Monitoring adalah strategi yang menjaga empat strategi lainnya tetap jalan.
Setup minimal yang kupakai:
usage di setiap respons adalah datamu yang paling berharga. Simpan, agregasikan harian, dan plot trennya.Satu temuan umum dari audit: satu endpoint atau satu fitur biasanya menyumbang 40–60% dari total biaya. Temukan itu, optimalkan itu, dan kamu dapat sebagian besar penghematan dengan sebagian kecil usaha.
Kalau bingung mulai dari mana, ikuti urutan ini berdasarkan rasio dampak-per-usaha:
max_tokens dan batasi retry — 30 menit kerja, dampak langsung.Tidak ada satu pun strategi di atas yang meminta kamu mengorbankan kualitas jawaban. Semuanya soal menghilangkan pemborosan: token yang dikirim tanpa perlu, model yang terlalu besar untuk tugasnya, pola bayar yang tidak cocok, dan kebocoran yang tidak terpantau. Hemat yang benar itu direkayasa, bukan dipangkas membabi buta.
Set max_tokens per use case dan batasi retry — bisa dikerjakan dalam 30 menit dan langsung memangkas pemborosan token output yang paling mahal. Setelah itu, padatkan system prompt karena ia dikirim ulang di setiap request.
Tidak selalu. Untuk tugas rutin seperti klasifikasi, ekstraksi, dan FAQ, model kecil memberi kualitas nyaris identik dengan model besar. Kuncinya adalah mencocokkan ukuran model dengan sulitnya tugas (routing bertingkat), bukan memakai satu model untuk semuanya. Uji dengan 50 sampel sebelum dan sesudah untuk memastikan.
Catat field usage dari setiap respons API, agregasikan per endpoint atau fitur, dan lihat kontribusinya ke total biaya. Biasanya satu fitur menyumbang 40–60% dari total — optimalkan itu dulu. Audit 15 menit seminggu cukup untuk menangkap masalah sejak kecil.
Saat pola pemakaianmu sudah stabil dan terukur selama 2–4 minggu. Kalau estimasi biaya pay-per-token-mu mendekati harga paket flat — misalnya paket Pro Rp50.000/30 hari — paket bulanan biasanya lebih hemat dan anggarannya pasti. Lihat perbandingan lengkapnya di AI router vs langganan langsung.
Ya, selama yang di-cache adalah hal yang memang deterministik: pertanyaan yang diulang persis sama, system prompt yang identik, atau dokumen referensi yang tidak berubah. Jangan cache jawaban yang seharusnya personal atau time-sensitive. Cache di level aplikasi untuk FAQ bisa memangkas 10–20% request tanpa menyentuh kualitas sama sekali.
Tidak ada model AI terbaik untuk semua hal. Framework praktis: definisikan tugas, uji A/B dengan prompt yang sama, ukur tiga metrik, mulai dari yang kecil.
Model AI lokal vs cloud: perbandingan jujur soal biaya, privasi data, latency, dan kualitas. Panduan lengkap memilih yang tepat untuk developer Indonesia.
Mulai sekarang
Mulai dari Rp5.000. Bayar QRIS atau USDC, langsung dapat API key.